


گوگل با معرفی دو مدل صوتی جدید به نامهای جمینای 3.8 Flash TTS و 3.8 Flash-Lite TTS، حوزه تبدیل متن به گفتار را متحول کرد. این مدلها به کاربران اجازه میدهند تنها با نوشتن چند خط متن، صداهایی کاملاً واقعی با لحن و احساسات دلخواه بسازند و دیالوگها را مانند یک کارگردان حرفهای مدیریت کنند. این ابزارها مستقیماً به سرویسهایی نظیر Gemini Notebook و ابزار ویدیویی Google Vids اضافه میشوند.
مدل Gemini 3.8 Flash TTS بهطور ویژه برای کارهای خلاقانه و صداپیشگی شخصیتها طراحی شده است. کاربران با ارسال دستورهای متنی ساده میتوانند صداهایی کاملاً جدید خلق کنند و از آنها در ساخت بازیهای ویدیویی، کتابهای صوتی و پادکستها بهره ببرند. در این ابزار میتوان ریتم بیان کلمات، احساسات و لحن صدا را در هر جمله تغییر داد.
در مقابل، مدل Gemini 3.8 Flash-Lite TTS برای پروژههای بزرگ با حجم بالا و هزینه اقتصادی کمتر بهینه شده است و گزینهای ایدهآل برای دوبله گسترده، تولید محتوای انبوه و ساخت دستیارهای صوتی محسوب میشود.
امکانات پیشرفته تبدیل متن به گفتار در جمینای 3.8 Flash TTS
فناوری جدید گوگل محدودیت صداهای تکراری و پیشفرض را برطرف کرده است. در مدل Gemini 3.8 Flash TTS میتوانید با نوشتن متن، جنسیت، نقش و لهجه صدا را در بیش از ۱۰۰ زبان و گویش گوناگون بسازید. صداهای گوناگونی در این مدل وجود دارد و میتوانید گزینه مدنظر خود را از صدای پرانرژی یک مجری رادیویی گرفته تا کاراکترهای انیمیشنی انتخاب کنید.
علاوهبرآن، بیش از ۲۰۰۰ صدای از پیشآماده در این پلتفرم قرار دارد. اگر بخواهید صدای خودتان را شبیهسازی کنید، تنها ارسال یک نمونه صوتی ۳۰ ثانیهای کافی خواهد بود تا پروفایل صدایتان با دقت بالا بازسازی شود. قابلیت ریمیکس صدا نیز بهزودی اضافه میشود تا بتوانید میزان زیروبمی، سرعت و لحن صداها را با یک متن ساده تنظیم کنید.
کنترل صدا در این مدلها دقیقاً شبیه اجرای یک نمایشنامه واقعی است. شما میتوانید در متن مشخص کنید گوینده در چهزمانی آرام صحبت کند، چهزمانی نجوا کند و چهزمانی هیجانزده شود. این سیستم در تولید فایلهای صوتی طولانی مثل پادکستها، یکدستی و کیفیت صدا را تا انتها حفظ میکند. علاوهبراین، امکان ساخت مکالمه همزمان میان دو کاراکتر وجود دارد و واکنشهای انسانی مثل خندیدن، نفس عمیق کشیدن، آه کشیدن و اصوات بین کلامی (مانند گفتن «بله» یا «آهان») بهشکلی باورپذیر اجرا میشوند.
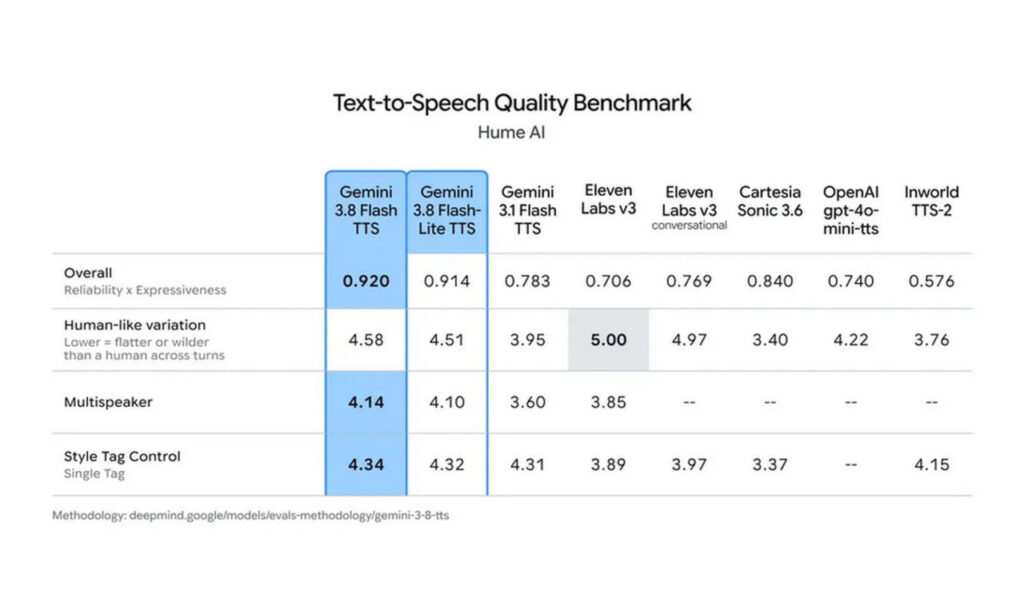
این ابزارها در بررسیهای تخصصی نیز عملکرد خیرهکنندهای ثبت کردهاند. مدل جمینای 3.8 Flash TTS رتبه نخست بنچمارک Hume AI در زمینه طراحی صدا و شبیهسازی لهجه را به دست آورده است. همچنین در ارزیابیهای ترجیح شنیداری پلتفرم Voice Arena، این مدلها در میان زبانهای مطرح جهانی جایگاههای برتر را تصاحب کردهاند.
برای جلوگیری از سواستفاده و حفظ حقوق هنرمندان، سازوکارهای امنیتی سختگیرانهای در نظر گرفته شده است. برای شبیهسازی صدا، کاربر باید صدای رضایت شفاهی صاحب صدا را ضبط و بارگذاری کند تا با فایل اصلی تطبیق داده شود. همچنین تمامی فایلهای صوتی تولیدشده به واترمارک صوتی نامحسوس فناوری SynthID مجهز هستند و اطلاعات هویتی استاندارد C2PA دارند تا غیرواقعی بودن صداها قابل پیگیری باشد.
این مدلها هماکنون از طریق Google AI Studio و Gemini API برای توسعهدهندگان، و در ابزارهایی مانند Gemini Notebook و Google Vids برای عموم در دسترس هستند.


نظرات کاربران