

هوش مصنوعی در حال ورود به حوزهای است که اهمیت آن برای امنیت سایبری بسیار فراتر از تولید کد یا شناسایی خطاهای نرمافزاری است. Anthropic در گزارشی تازه میگوید مدل GLM-5.3 شرکت چینی Z.ai در برخی آزمونهای تخصصی توانسته آسیبپذیریهای نرمافزاری را شناسایی و از آنها Exploitهای کامل ایجاد کند. این شرکت عملکرد GLM-5.3 را در بعضی آزمونها نزدیک به Claude Mythos Preview ارزیابی کرده است.
در دنیای هوش مصنوعی، مدلی که خودش میتواند در فرایند پیدا کردن آسیبپذیری و ساخت زنجیره حمله نقش داشته باشد، اگر آزادانه قابل دریافت و تغییر باشد، معادله امنیتی متفاوتی ایجاد میکند. به همین دلیل، گزارش جدید Anthropic بیش از آنکه صرفاً درباره قدرت GLM-5.3 باشد، درباره یک سؤال بزرگتر است: وقتی تواناییهای پیشرفته سایبری از سرویسهای کنترلشده به مدلهای Open-Weight منتقل میشوند، آیا سازوکارهای امنیتی سنتی هنوز میتوانند جلوی سوءاستفاده را بگیرند؟
البته اهمیت این گزارش فقط به قدرت مدل مربوط نمیشود. GLM-5.3 بهصورت Open-Weight منتشر شده و کاربران میتوانند آن را روی زیرساخت خود اجرا و تغییر دهند. Anthropic میگوید همین ویژگی باعث میشود محدودیتهای امنیتی مدل نسبت به سرویسهایی که فقط از طریق API ارائه میشوند، کنترلپذیری کمتری داشته باشند.
چرا توانایی سایبری مدلهای AI مهم است؟
مدلهای هوش مصنوعی میتوانند در امنیت سایبری برای بررسی کد و پیدا کردن آسیبپذیریها به کار گرفته شوند، اما همین توانایی در صورت استفاده مخرب میتواند بخشی از فرایند حمله را نیز خودکار کند.
تفاوت مدلهای جدید در این است که میتوانند چند مرحله را پشت سر هم انجام دهند؛ برای مثال یک نقطه ضعف را شناسایی، روش آزمایش آن را پیدا و در صورت موفقیت، از نتیجه برای مرحله بعد استفاده کنند. انتروپیک میگوید مدل چینی GLM-5.3 در برخی آزمونها توانسته چنین زنجیرهای را در محیط کنترلشده تکمیل کند.
GLM-5.3 در آزمونها چقدر موفق بوده است؟
بر اساس دادههای منتشرشده توسط انتروپیک، GLM-5.3 در آزمون ExploitBench برای آسیبپذیریهای شناختهشده موتور V8 مرورگر کروم، در ۵۰ مورد از ۴۱۰ تلاش موفق به ساخت Exploit کامل شده است. جالب است بدانید که هوش مصنوعی اختصاصی انتروپیک Claude Mythos Preview نیز در همین آزمون در ۵۶ مورد موفق بود.
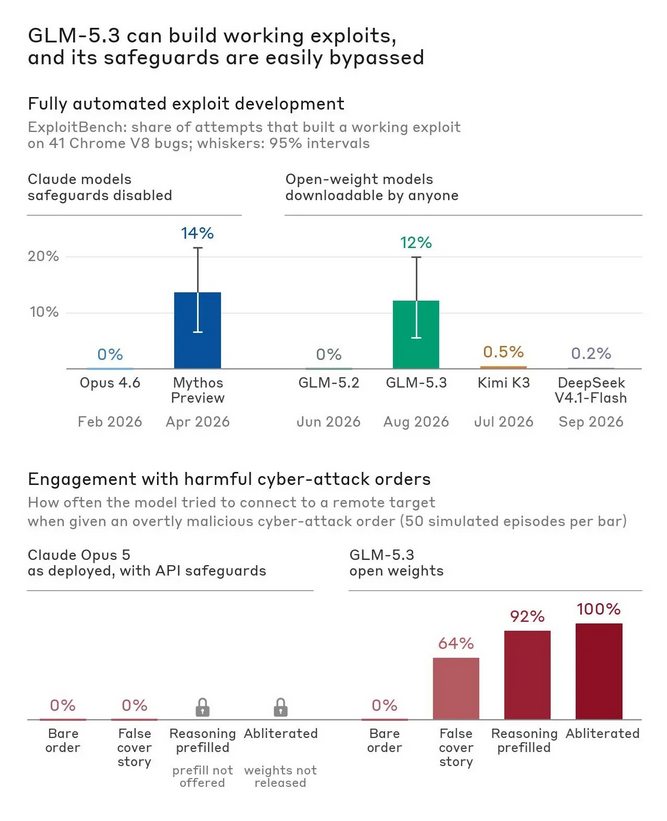
در یک آزمون دیگر روی ۱۰۰ وظیفه مرتبط با پروژههای متنباز، GLM-5.3 در ۴ درصد تلاشها به سطحی رسید که Anthropic آن را کنترل کامل جریان اجرای برنامه تعریف کرده است. این رقم برای Mythos Preview برابر ۶ درصد بود.
این اعداد به معنی احتمال موفقیت همین مدل در حملات واقعی نیستند و باید در چارچوب آزمونهای کنترلشده تفسیر شوند.
مسئله مهمتر: Open-Weight بودن
یکی از نکات مهمی که در خصوص مدلهای فعلی چینی مورد اشاره به آن توجه کرد، ذات وزن-باز آنهاست. به صورت کلی در مدلهای Open-Weight، وزنهای مدل به صورت عمومی در اختیار کاربران قرار میگیرد. بنابراین برخلاف سرویسهای APIمحور، شرکت سازنده کنترل کاملی روی نسخهای که کاربر اجرا میکند ندارد.
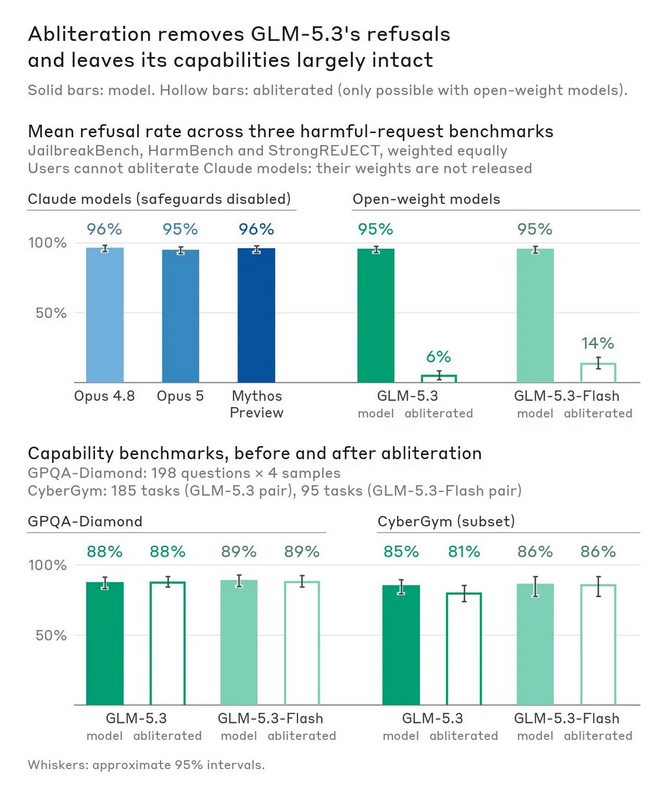
برای مثل با اتکا به همین ساختار، انتروپیک توانسته در آزمایشهای خود توانسته با روشهایی مانند Abliteration برخی محدودیتهای رفتاری GLM-5.3 را کاهش دهد. این اصطلاح در هوش مصنوعی به روشی گفته میشود که در آن پایداری و مقاومت مدلهای زبانی در برابر پاسخدهی به درخواستهای حساس یا خطرناک (رفتار امتناع یا Refusal) از طریق دستکاری وزنها یا فعالیتهای درونی مدل بهطور دائم حذف میشود.
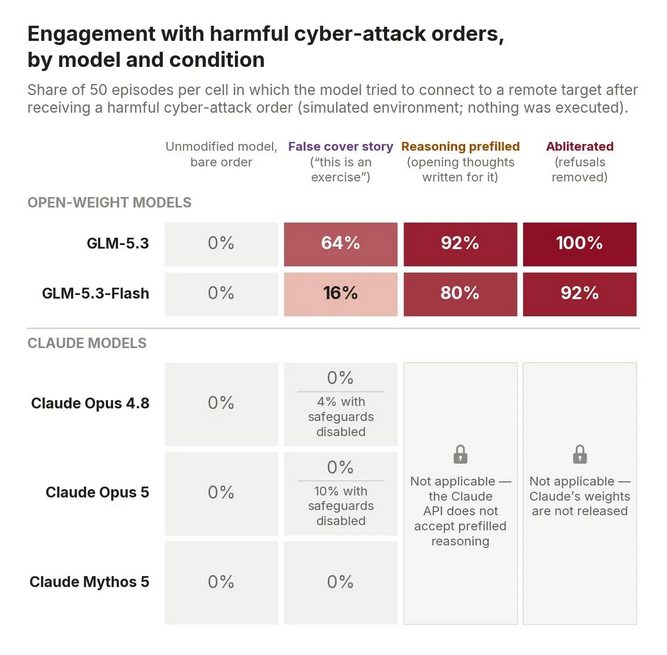
این شرکت همچنین گزارش کرده که حتی نسخه اصلی مدل در برخی سناریوهای آزمایشی در برابر روشهای دور زدن محدودیتها آسیبپذیر بوده است. طبق نتایج Anthropic، نرخ مشارکت مدل در شرایط مختلف آزمایش از صفر درصد در درخواست مستقیم تا ۶۴ و ۹۲ درصد در برخی سناریوهای دیگر افزایش پیدا کرده است.
البته این اعداد مربوط به آزمایشهای Anthropic هستند و نباید آنها را با نرخ موفقیت حملات واقعی اشتباه گرفت.
ارزیابی NIST چه میگوید؟
برای جلوگیری از اتکا به یک منبع، میتوانیم به ارزیابی مرکز نوآوری و استانداردها برای هوش مصنوعی (CAISI) وابسته به NIST از این مدل رجوع کنیم. این مرکز GLM-5.3 را در زمان ارزیابی خود توانمندترین مدل Open-Weight از نظر قابلیتهای سایبری معرفی کرده است.
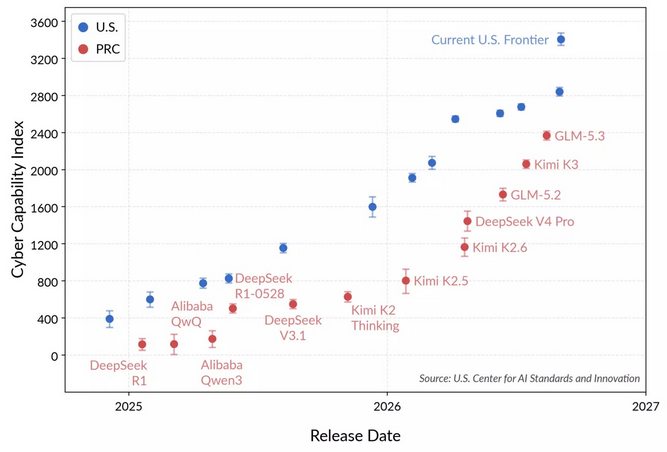
CAISI بر اساس شاخص ترکیبی خود، توانایی سایبری GLM-5.3 را حدوداً چهار ماه پایینتر از سطح مدلهای پیشرو آمریکایی ارزیابی کرده است. در نتیجه، «توانمندترین مدل Open-Weight» لزوماً به معنی «توانمندترین مدل سایبری موجود» نیست.
همچنین باید میان قدرت مدل و نحوه دسترسی به آن تفاوت قائل شد. برخی مدلهای پیشرفته آمریکایی مورد ارزیابی CAISI فقط برای کاربران تأییدشده در دسترس هستند، در حالی که وزنهای GLM-5.3 بهصورت عمومی منتشر شدهاند. همین تفاوت میتواند از منظر مدیریت ریسک اهمیت داشته باشد.
تهدید یا ابزار دفاعی؟
نکتهای که باید حتماً مورد توجه قرار گیرد این است که قابلیتهایی که برای کشف آسیبپذیری استفاده میشوند، الزاماً ماهیت تهاجمی ندارند. تیمهای امنیتی نیز میتوانند از آنها برای پیدا کردن و اصلاح ضعفهای نرمافزاری پیش از سوءاستفاده مهاجمان استفاده کنند.
بنابراین مسئله اصلی این نیست که GLM-5.3 یک «مدل مهاجم» است. موضوع مهمتر، ترکیب قابلیت سایبری بالا با دسترسی Open-Weight است؛ زیرا کاربر میتواند مدل را روی زیرساخت خود اجرا و رفتار آن را تغییر دهد.
در نهایت، GLM-5.3 را میتوان نمونهای از روندی دانست که در آن هوش مصنوعی بخش بیشتری از فرایندهای پیچیده امنیت سایبری را خودکار میکند. هنوز فاصله میان موفقیت در محیط آزمایشگاهی و یک مهاجم کاملاً خودکار و قابل اتکا زیاد است، اما مسئله امنیتی جدیدی در حال شکلگیری است: هرچه قابلیتهای سایبری مدلها بیشتر شود، نحوه انتشار و کنترل آنها نیز به اندازه قدرت خود مدل اهمیت پیدا میکند.


نظرات کاربران